Orquestra Studio
Três agentes de código, um pedido. O Orquestra planeja, divide em tarefas, roda as independentes em paralelo, cada uma na sua cópia do Git, testa, pede a revisão a um agente de outro fornecedor e integra uma de cada vez. Quem aprova o plano e a entrega é a pessoa.
- Papel
- Autor, projeto pessoal
- Período
- out/2026
- Situação
- em andamento
- LLMs e agentes
- Node.js
- React
- TypeScript
- Vite
- Git worktrees
- Playwright
- Codex
- Claude Code
- Antigravity
Compreensão simples
O problema
Quem trabalha com mais de uma IA de programação vira o elo entre elas. Abre uma janela para cada, copia à mão o que uma fez para a outra e guarda na cabeça quem faz o quê, e em que ordem.
Deixar as IAs trabalhando sozinhas por horas traz outro risco: usar a mais forte, e a mais cara, numa tarefa simples que uma menor resolvia. E, no fim, falta a prova de que o resultado foi testado e conferido.
O que faz
- Transforma o pedido num plano
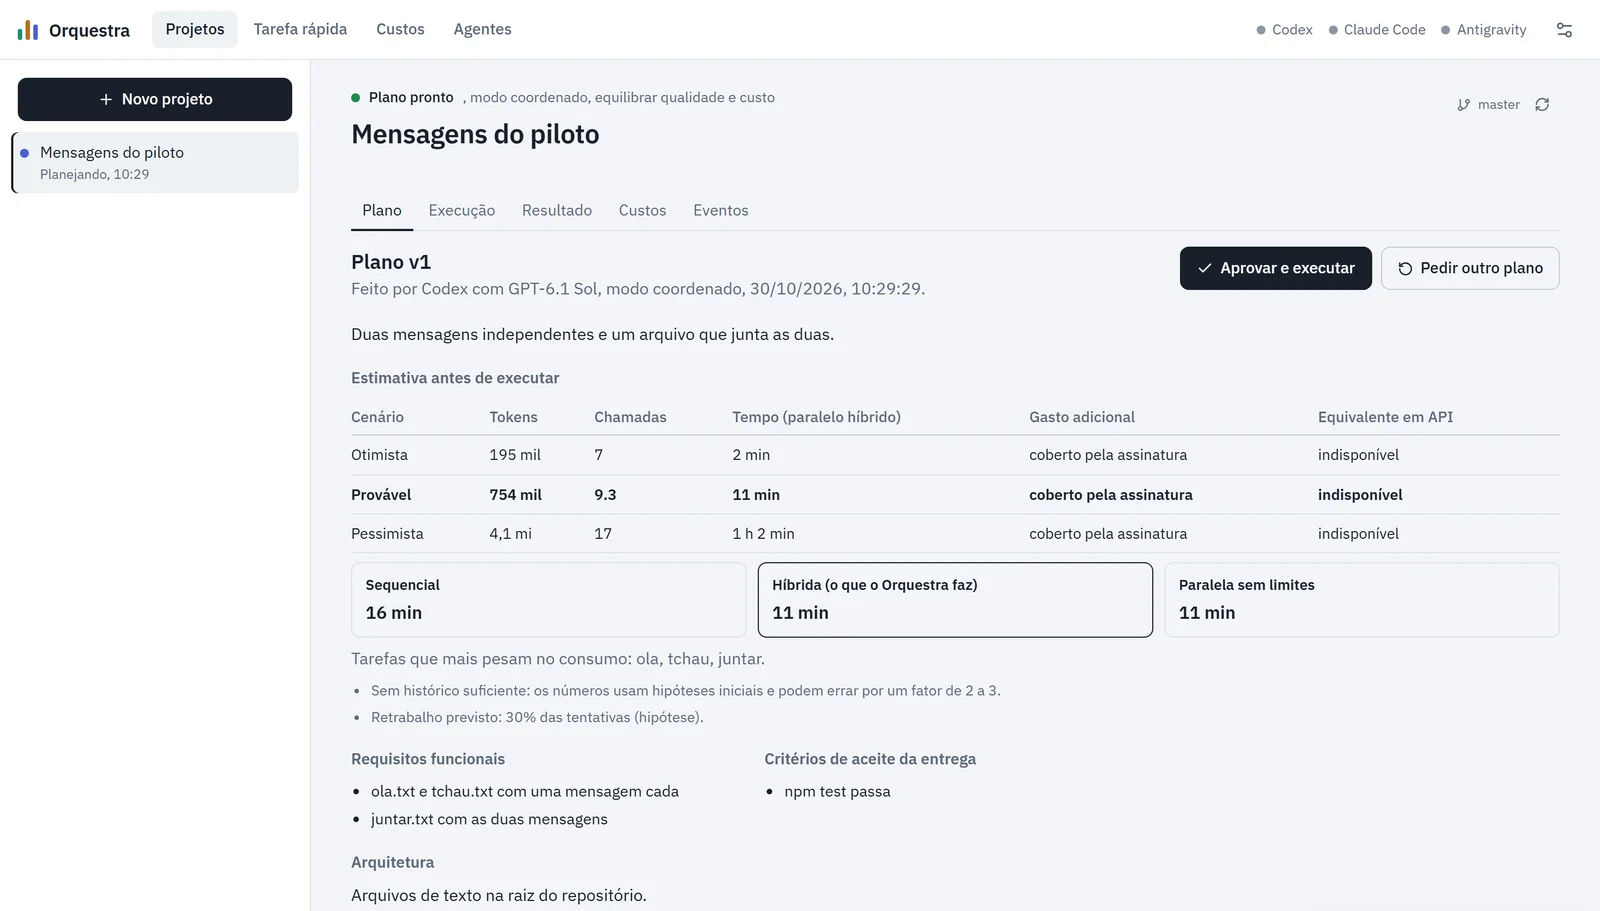
Você descreve o que quer. Uma das IAs divide o trabalho em tarefas e mostra o que depende do quê, com uma previsão de tempo e de consumo. Nada começa antes de você aprovar.
- Escolhe quem faz cada parte
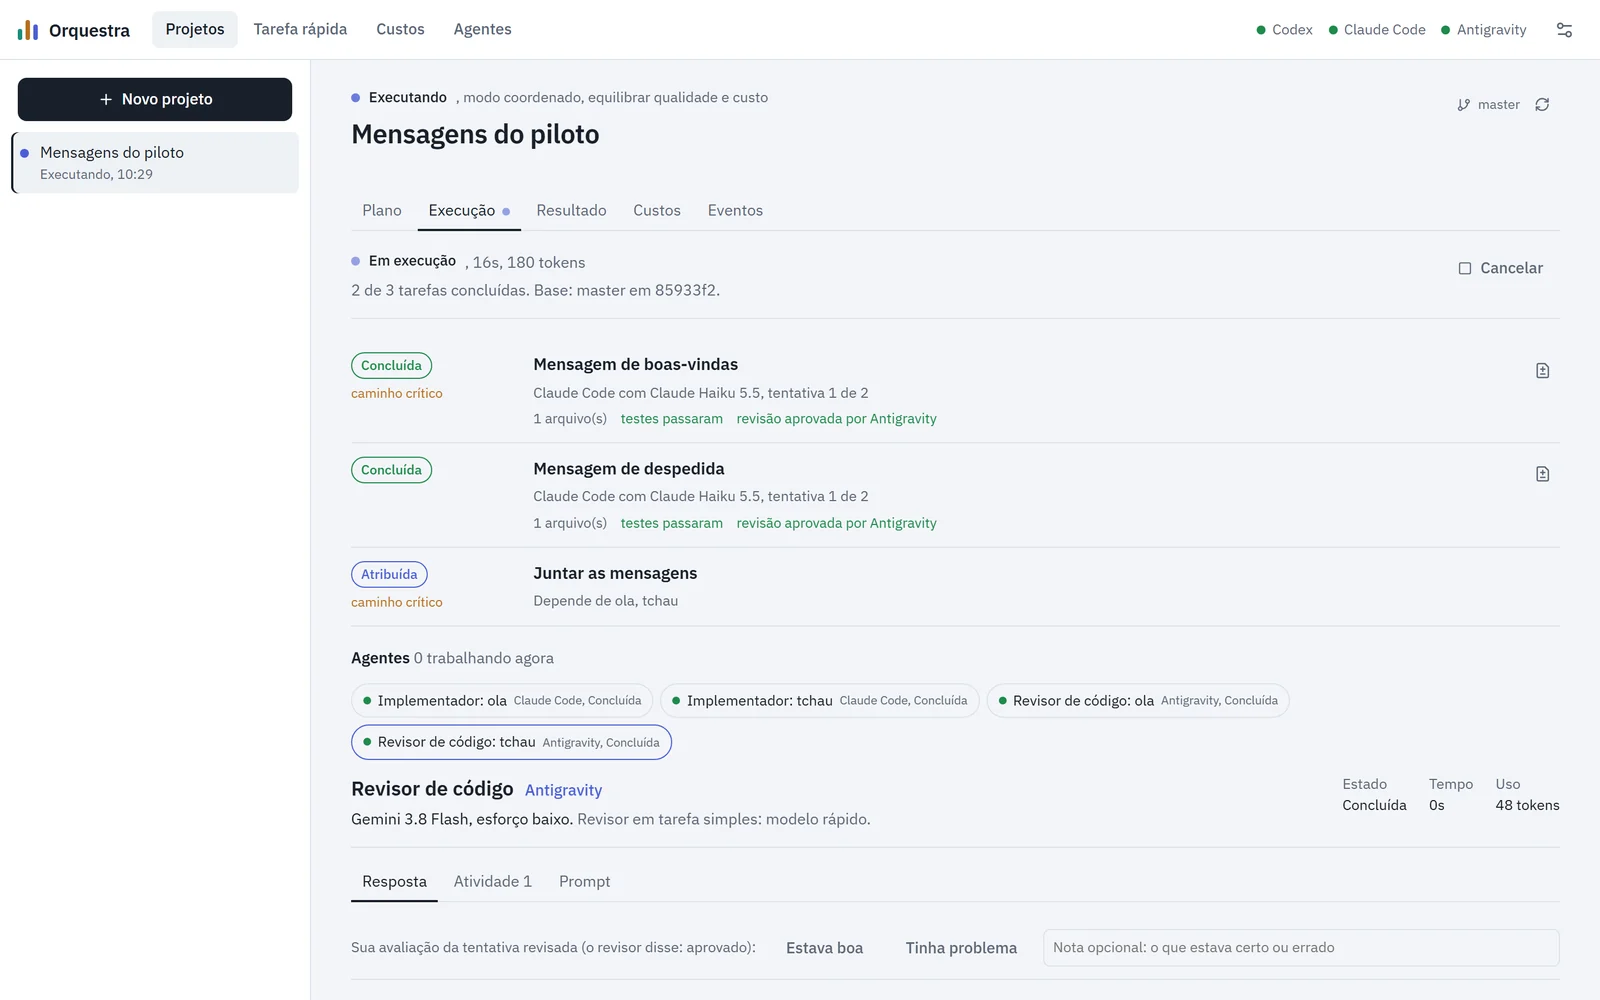
Uma IA planeja, outra executa e uma terceira confere. O painel escolhe qual versão de cada IA usar em cada função e, se uma fica indisponível, passa a vez para a próxima da fila.
- Faz várias tarefas juntas
As tarefas que não dependem umas das outras andam ao mesmo tempo, cada uma numa cópia separada do projeto, para uma não atrapalhar a outra.
- Só entra o que foi conferido
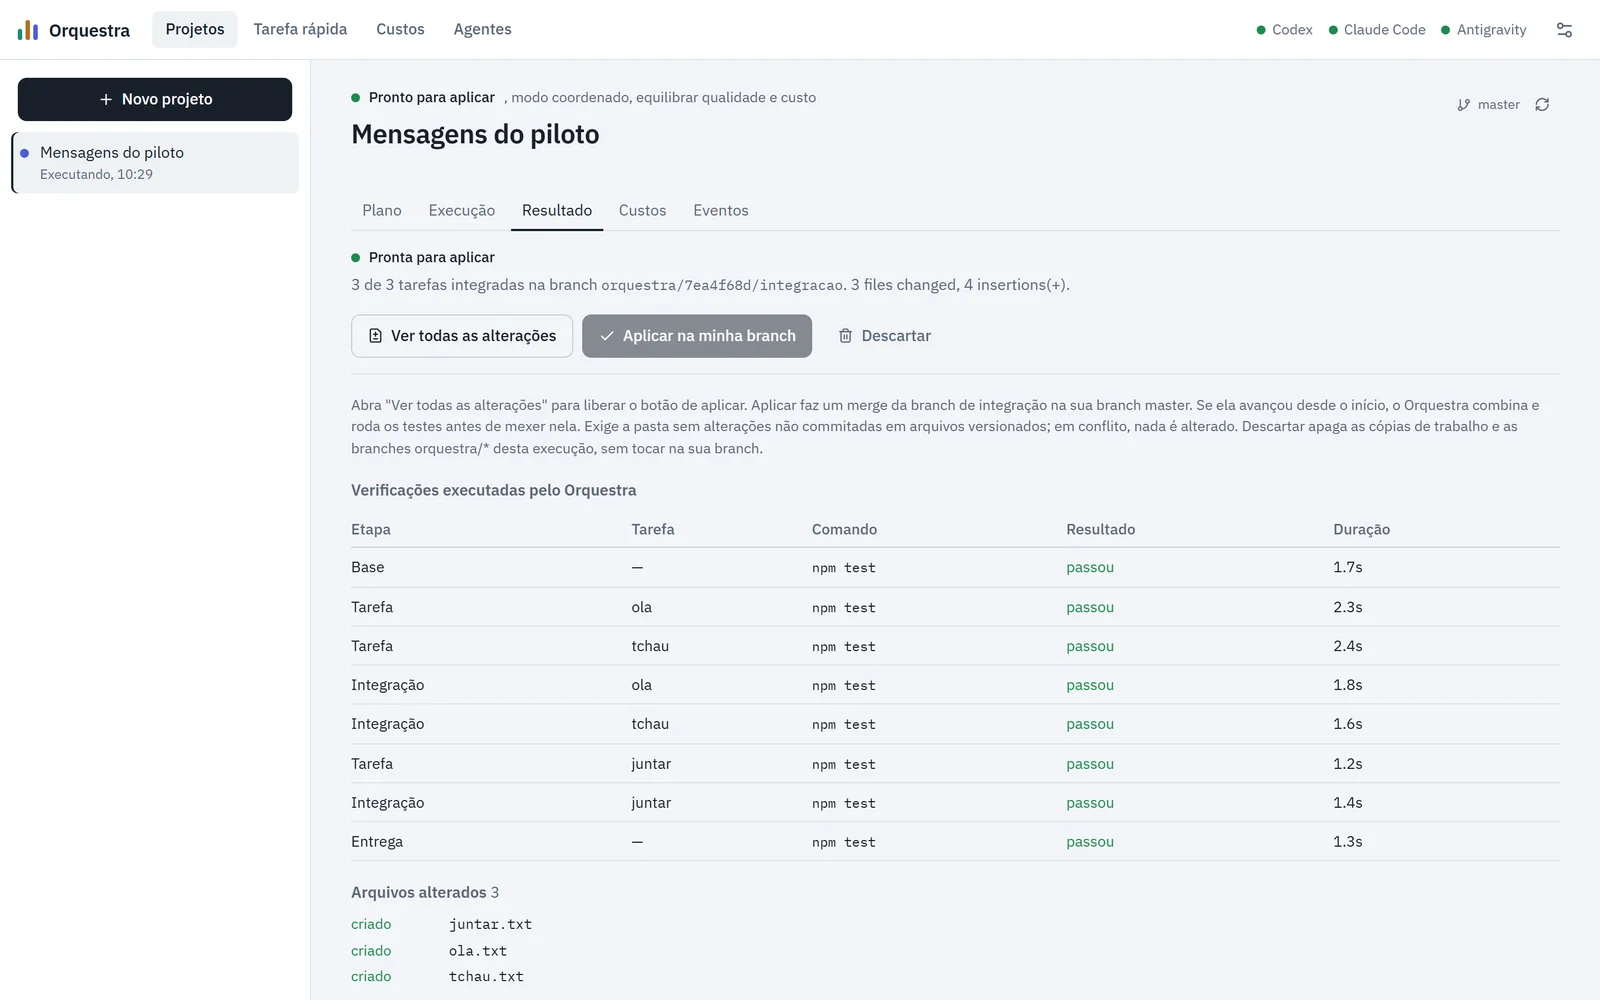
Cada tarefa passa pelos testes do projeto e pela leitura de uma IA de outra empresa; se ela pede ajustes, a tarefa volta. O seu projeto só muda quando você abre as alterações e aplica.
Na tela
As telas mostram um projeto de teste, com uma IA simulada no lugar das três.
Toque fora da imagem para fechar.
Toque fora da imagem para fechar.
Toque fora da imagem para fechar.
O que muda
1,38×
A pessoa deixa de ser o elo entre as IAs. Ela descreve o pedido, aprova o plano e confere a entrega; a ordem, as cópias e a conferência ficam com o painel.
E a entrega chega com a prova: cada tarefa com os testes e a conferência registrados, da versão de partida ao resultado final.
Numa rodada de teste, o registro de cada passo mostrou que 84% do consumo era a IA relendo o que já tinha lido. Daí vem o próximo passo: escolher a IA e o esforço certos para cada tarefa e aprender com cada rodada, para gastar menos a cada projeto. Pode servir a qualquer pessoa ou equipe que já trabalha com mais de uma IA.
Compreensão técnica
Problema, otimização e resultado
- Problema
- Três agentes de código, Codex, Claude Code e Antigravity, cada um no seu terminal: o contexto passa de um para o outro à mão, a divisão, a ordem e a integração ficam na cabeça de quem opera, e não há como provar que o resultado foi testado e revisado. Num ciclo que roda por horas, há ainda o risco de usar um modelo grande, em esforço alto, onde um menor bastava.
- Otimização
- Um núcleo determinístico em Node.js, pelas CLIs oficiais e pela assinatura. O planejador devolve tarefas em JSON validado no código; as independentes rodam em paralelo, cada uma numa worktree do Git, passam pelos testes do projeto e pela revisão de outro fornecedor, e entram na integração uma de cada vez. O modelo é escolhido por função e complexidade, e o consumo fica registrado por chamada, com o que a CLI não informa marcado como indisponível.
- Resultado
- Com as três CLIs reais, em repositórios de teste: 4 tarefas, 10 chamadas e 0 falhas em 19/10/2026, com 18 de 18 testes na entrega; 1,38× de paralelização com 3 tarefas em 20/10 (tempo somado dos agentes sobre o tempo de relógio, 8 de 8 verificações). O registro por chamada de 19/10 mostrou que 84% dos 1,85 milhão de tokens eram contexto relido do cache; o relatório de custo passou a apontar a causa, e é esse dado que orienta a escolha de modelo e esforço por tarefa.
Evidências
Ciclo completo com as três CLIs reais: 4 tarefas, 10 chamadas, 0 falhas
Validação de 19/10/2026 num repositório de teste: o Codex planeja, o Claude Code implementa e o Antigravity revisa; quatro integrações com os testes depois de cada uma, e 18 de 18 testes na entrega. Uma revisão pediu ajustes, e a segunda aprovou.
Medido.
Paralelização de 1,38× com três tarefas
Validação ao vivo de 20/10/2026, com 2 tarefas independentes e 1 dependente: 6 sessões reais e 8 de 8 verificações. O tempo somado dos agentes dividido pelo tempo de relógio, num projeto de teste pequeno.
Medido.
121 testes automáticos passando
Rodados em 30/10/2026 na base 0.7.1: unidade e integração com Git real, comandos de teste reais e agentes simulados, sem credencial nem cota.
Medido.
As travas no código
O que pode dar errado com um agente editando arquivos fica preso no código, não no prompt:
- os testes rodam na base antes de qualquer agente, e uma base quebrada para a execução sem gastar cota;
- a tentativa que altera
.env, chaves ou certificados é descartada antes do commit; - agentes e testes rodam sem as variáveis de ambiente com cara de segredo;
- o planejador e os revisores só leem, e os comandos ficam bloqueados até a pessoa permitir;
- o serviço escuta só em 127.0.0.1 e recusa outras origens;
- o Orquestra só cria e apaga branches
orquestra/*, e a branch da pessoa só muda quando ela aplica.
Quando um agente fica sem cota, sem login ou sem rede, a função passa para o próximo da fila, e o motivo de cada escolha de modelo fica registrado na sessão.
Na tela
Toque fora da imagem para fechar.
Toque fora da imagem para fechar.
Toque fora da imagem para fechar.
Como funciona
Como numa partitura, cada tarefa tem a sua faixa: sai da linha da integração, passa pelos testes e pela revisão, e só então volta a ela.
- Plano
O planejador lê um retrato da pasta, sem .env nem chaves, e devolve tarefas em JSON; o código valida as dependências, e a pessoa aprova.
JSON - Cópias
Cada tarefa pronta ganha uma worktree e uma branch próprias; tarefas com arquivos em comum não rodam juntas.
Gitaté 4 em paralelo - Testes
O implementador altera os arquivos e o Orquestra roda os testes do projeto; se falham, a saída volta ao implementador.
npm test - Revisão
Um agente de outro fornecedor lê o diff e a conferência automática, e termina com APROVADO ou AJUSTES.
- Integração
Só a tarefa aprovada entra, uma de cada vez, com os testes depois de cada merge.
merge --no-ff - Entrega
Os testes rodam na integração completa; a branch da pessoa só muda quando ela abre as alterações e aplica.
O modelo entra em pontos definidos, e o que ele devolve é validado: estados, escalonamento, isolamento, testes e integração são código. Ao lado, uma tarefa do plano como o planejador a entrega.
Nenhuma tarefa fica pronta porque o agente disse. O revisor nunca é do fornecedor de quem implementou, e sem revisor disponível a tarefa para.
{
  "id": "juntar",
  "title": "Juntar as mensagens",
  "dependsOn": ["ola", "tchau"],
  "files": ["juntar.txt"],
  "acceptance": ["juntar.txt existe"]
}
Decisões
Em vez de: Um framework multiagente em que o modelo conduz o fluxo.
Custo aceito: Mais código próprio para estados, escalonamento e integração.
Em vez de: Agentes editando a mesma pasta ao mesmo tempo.
Custo aceito: Exige um repositório com pelo menos um commit; no Windows, nomes curtos para fugir do limite de caminho do Git.
Em vez de: O mesmo agente conferindo o próprio trabalho.
Custo aceito: Uma chamada a mais por tarefa, e a tarefa para quando nenhum revisor está disponível.
Em vez de: Juntar tudo no fim e resolver os conflitos de uma vez.
Custo aceito: A integração vira fila, com os testes depois de cada merge.
Em vez de: Chamar as APIs e pagar por token.
Custo aceito: Depende da cota de cada plano; quando uma acaba, a função passa para o próximo agente da fila.
Em vez de: Preencher com estimativa o que a CLI não informa.
Custo aceito: Telas com lacunas declaradas; o equivalente em API só aparece com um preço cadastrado, com fonte e data.
Como foi construído
- 19/10As três CLIs reais
O demo vira execução real pelo Codex, pelo Claude Code e pelo Antigravity, com a escolha de modelo por função.
- 19/10O modo projeto
Plano validado, tarefas com dependências, worktrees em paralelo, revisão cruzada e integração em fila.
- 19/10A primeira execução real
Quatro tarefas, 10 chamadas e nenhuma falha; os agentes reais revelam 5 defeitos que os simulados não mostravam.
- 19/10A revisão externa
Dois pareceres independentes, cada afirmação conferida no código antes de aceitar; 6 estavam erradas ou imprecisas.
- 20/10A versão 0.7.1
A segunda rodada de revisão e a validação ao vivo com as três CLIs, com 8 de 8 verificações.
Projetei e construí dirigindo o Claude Code e o Codex, com os testes e as revisões como portão. Cada defeito visto ao vivo ficou registrado no plano de testes, com a correção e o teste que o cobre.
Limites
- Esta página descreve o ciclo principal da base 0.7.1, validado ao vivo com as três CLIs em repositórios de teste.
- O próximo passo é guardar cada rodada, com o modelo, o esforço, o consumo e o veredito da revisão, e usar esse histórico para escolher o modelo e o esforço da próxima tarefa e estimar o gasto antes de rodar.
Hoje e a seguir
Hoje
A base 0.7.1 roda no meu computador com as três CLIs. O Orquestra continua mudando; esta página descreve o ciclo principal, que é o que já foi validado ao vivo.
A seguir
- Uma execução de ponta a ponta num projeto real, do plano ao aplicar.
- Validar ao vivo o modo avançado, com o analista que faz perguntas, o revisor de segurança e um conflito real resolvido na integração.
- Rotular de 30 a 50 revisões reais para medir quanto o revisor acerta, antes de mexer no prompt dele.
As imagens são da interface rodando com o projeto sintético dos testes, com um agente simulado no lugar das CLIs: os nomes de modelo que aparecem nelas vêm do catálogo, não de uma execução real.